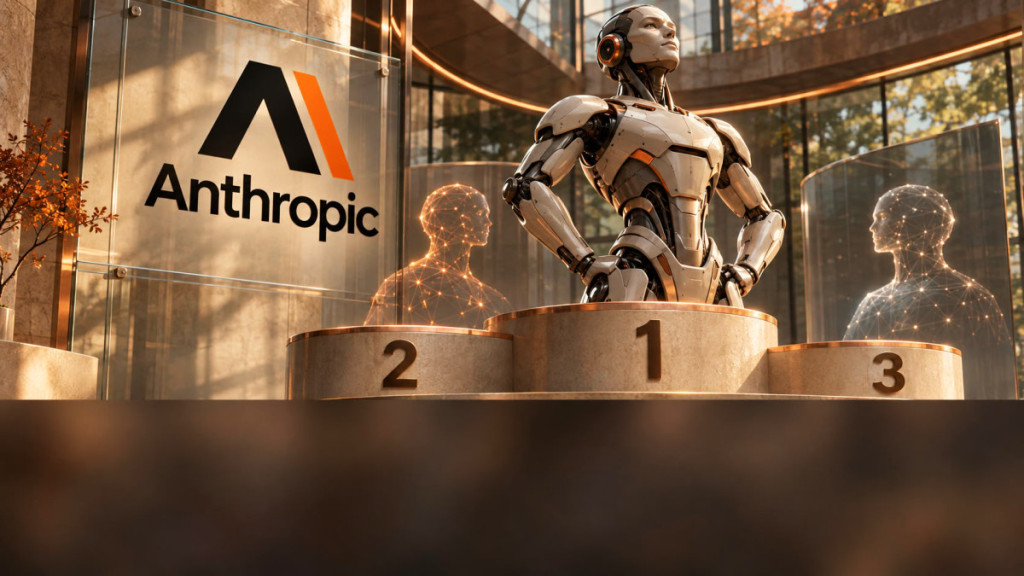
Anthropic conserve la première place du classement Agent Arena pour les tâches agentiques en novembre 2026, devant Google et OpenAI. Cette mise à jour du benchmark, piloté par Arena (ex-LMArena, ex-Chatbot Arena), mesure les performances des modèles à partir de centaines de milliers d’interactions enregistrées dans son environnement sandbox. Ce classement permet de comparer des modèles qui pilotent des agents IA, c’est-à-dire des programmes capables d’exécuter seuls des tâches complexes en plusieurs étapes.
Anthropic en tête, Google qui se rapproche
Dévoilé récemment, Claude Fable 5.2 prend la tête du classement. Évalué avec un niveau de réflexion réglé sur « Max », comme la plupart de ses concurrents, le modèle d’Anthropic affiche un score de Net Improvement de 28,6 %, contre 18,1 % pour Claude Opus 5.5, auquel il succède en haut du classement. Pour établir ce score, Arena agrège l’ensemble des signaux recueillis pendant les tests, puis le compare à celui du « modèle moyen ». « Un score positif indique une performance supérieure à la moyenne, un score négatif une performance inférieure », précise la plateforme.
Google progresse également. Gemini 4 Carbon, le modèle le plus abouti de l’entreprise, reste réservé à un cercle restreint d’acteurs de la cyberdéfense, mais il se classe troisième. Gemini 4 Hydrogen, déployé sur Gemini, sur l’API et sur le moteur de recherche, arrive quatrième, entre Claude Sonnet 5.5 et Claude Fable 5.1. En revanche, Gemini 4 Argon, quatrième le mois précédent, sort du top 10. Celui-ci comprend trois modèles d’OpenAI : GPT-6 Astra (7e), GPT-6.1 Sol (9e) et GPT-6.1 Terra (10e).
Le classement complet, avec les scores de chaque modèle, est consultable sur le site d’Arena.
Une méthode fondée sur des sessions réelles
Pour ce classement, l’équipe d’Arena utilise une méthodologie baptisée causal tracing, distincte de celle employée pour son classement général. La plateforme analyse des millions de sessions menées dans son Mode Agent, un environnement sandbox où les utilisateurs confient des workflows à un agent doté de différents outils, comme la recherche web ou la génération d’images. Pour départager les modèles, Arena change au hasard, d’une session à l’autre, le modèle qui pilote l’agent.
Plusieurs critères entrent en jeu. Arena observe si l’utilisateur approuve ou rejette les résultats, s’il complimente ou dénigre l’agent dans ses messages et s’il s’améliore lorsqu’on le reprend. La plateforme compte aussi le nombre d’essais nécessaires après une requête infructueuse et vérifie si l’agent crée des outils qui n’existent pas.
Product offers are temporarily unavailable.